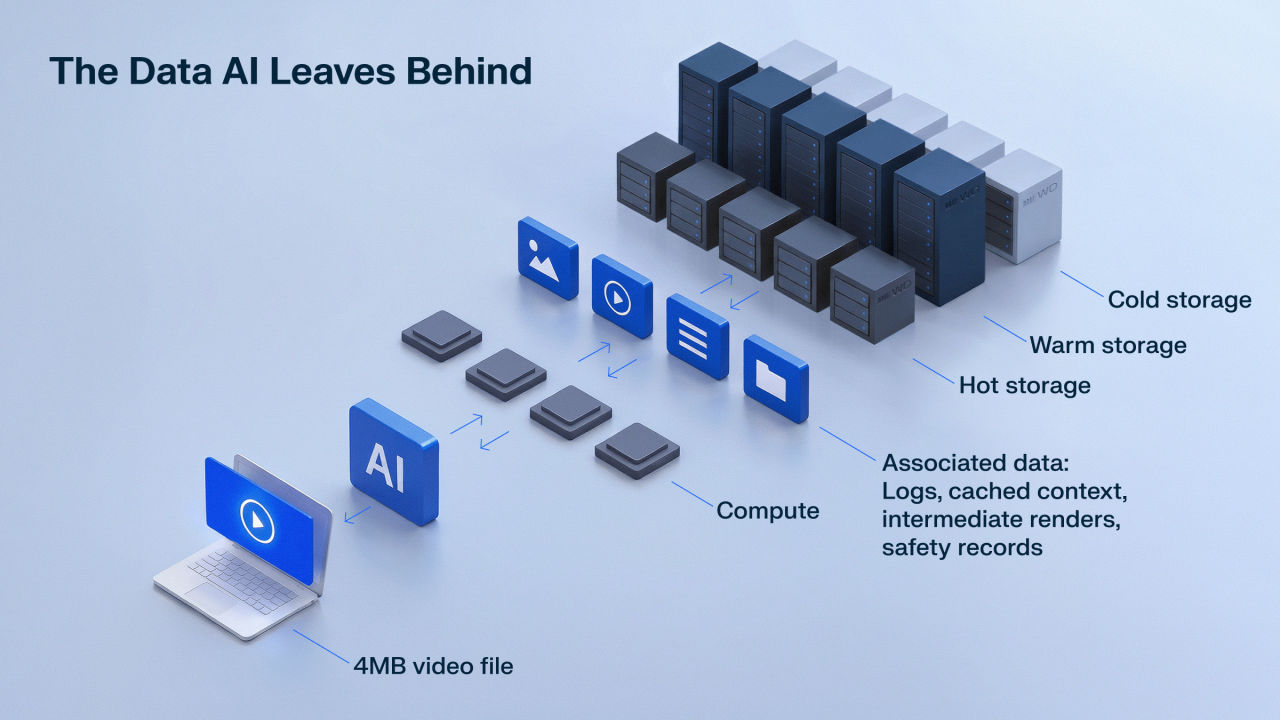
MIT Technology Review 发布文章《AI's hidden storage bill: What inference leaves behind》,把讨论焦点从模型训练转向推理阶段留下的数据。从标题看,文章关注的是:模型持续对外提供服务时,推理过程产生的数据会留存下来,由此形成一笔容易被忽视的存储开销。
过去一段时间,围绕 AI 成本的讨论多集中在训练侧,例如算力、芯片与集群规模;推理则常被当作运行环节,其成本容易被简化为单次调用开销。但推理是高频、持续、面向真实请求的过程,留下的数据会随时间累积,形成长期账单,这也是标题中“hidden”所指的方向。
对 AI 从业者来说,这一视角的意义在于扩展成本核算与系统设计的边界:模型上线并非终点,推理数据的留存、存储与后续处理,同样需要纳入考量。对关注 AI 基础设施的团队而言,这类议题直接关系到成本透明度与容量规划;如果把推理只看作一次调用,就很难解释存储侧为何持续增长。文章将这一问题单独提出,也提示在评估 AI 系统总拥有成本时,需要把“留下了什么”与“算得多快”放在一起考虑。
原文链接:https://www.technologyreview.com/2026/10/22/1146948/ais-hidden-storage-bill-what-inference-leaves-behind/