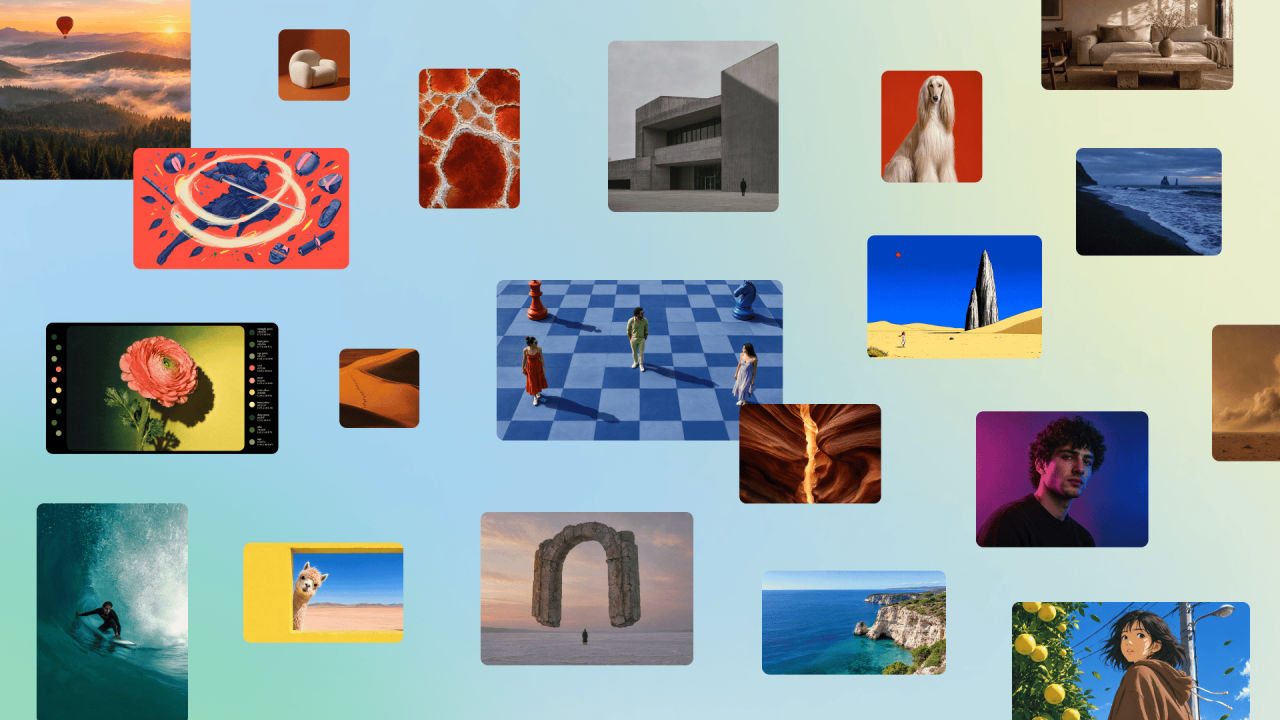
据 The Verge 报道,设计平台 Canva 公布了其首个自研 AI 图像模型。与常见的“输入提示词、直接出图”的路径不同,该模型的核心思路是“先规划、后生成”:在真正渲染画面之前,先对设计本身进行规划,再据此产出图像。
这一顺序上的调整值得注意。对通用文生图模型而言,用户往往需要在多次试错中筛选结果,提示词与最终画面之间的关系并不稳定。而在真实的设计工作流里,图像很少孤立存在:它需要落到具体的版式、尺寸、留白与文字位置上。Canva 提出的“先规划”环节,指向的正是这一层需求,也就是把设计意图前置为生成过程的一部分,让模型在出图前就明确画面要服务于什么样的版式结构,而不只是生成一张好看的图片。
从厂商策略看,“自研”本身也是这条消息的关键词。作为面向大众市场的设计工具,Canva 推出 in-house 模型,意味着其在图像生成能力上开始建立自有模型资产,而不仅依赖外部模型供给。对于处于应用层的设计类产品来说,自研模型的价值通常体现在两处:一是可以针对自身场景做定向优化,二是能在生成环节与编辑、排版等产品能力更紧密地衔接。“先规划后生成”这一设计,恰好属于只有深度绑定具体工作流才容易做成的优化方向。
对 AI 从业者而言,这条消息提供了一个观察窗口:图像生成模型的竞争,正在从单纯的画质与风格表现,延伸到对任务结构的理解与可控性。设计、电商、营销物料等场景对“可用性”的要求远高于“惊艳感”,能否稳定输出符合版式约束的结果,往往比单张图的效果更决定产品体验。
目前 Canva 方面披露的信息集中于模型思路本身,具体的生成质量、上线范围与使用方式仍有待观察。该模型能否把“先规划”转化为实际可用性的提升,将是后续检验的重点。