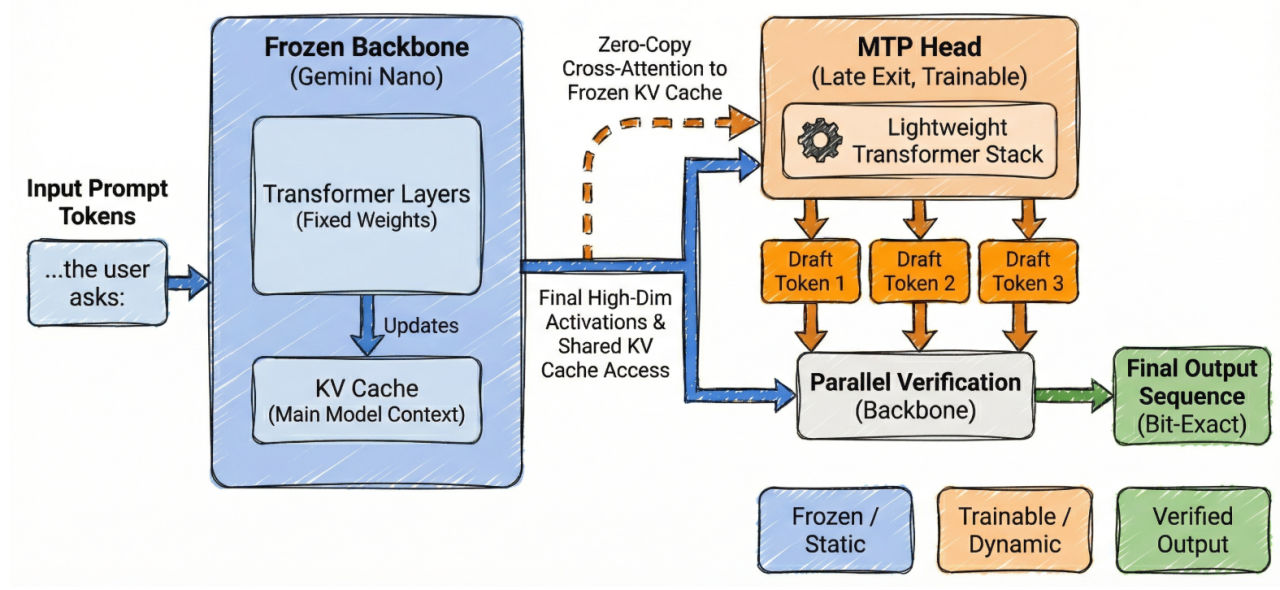
Google Research 发布博客,介绍在 Pixel 手机上以“冻结的多 AI 词典:Token">Token 预测(frozen Multi-Token Prediction,MTP)”加速 Gemini Nano 模型。从标题与主题看,这项工作属于端侧推理加速:让 Gemini Nano 在 Pixel 设备上运行得更快,而实现手段是把多 Token 预测与“冻结”策略结合。原文链接为 research.google/blog/accelerating-gemini-nano-models-on-pixel-with-frozen-multi-token-prediction/。
什么是多 Token 预测
常规自回归解码每一步只输出下一个 token,逐个生成,延迟随输出长度线性累积。多 Token 预测让模型在一次前向计算中同时给出多个未来位置的 token 候选,再通过校验或选择机制确定最终输出。这类思路在推理加速领域已被广泛讨论,常与投机解码(speculative decoding)一类方法相提并论:用较小的计算代价换取更高的有效吞吐。
“冻结”的含义与价值
标题中的 frozen 表明,参与多 Token 预测的组件以冻结参数的形式工作,而不是与主模型一起在线更新。对端侧部署而言,这一点值得关注:冻结意味着额外的预测模块可以独立训练或适配后固定下来,主模型权重无需为加速而反复改动,从而降低适配与维护成本,也更容易在多个设备型号上复用。对于需要在有限内存、功耗与算力预算下运行大模型的手机端场景,这类“插件式”加速模块比重新训练整个模型更具工程可行性。
为什么重要
Gemini Nano 是 Google 面向端侧设备的模型系列,其实际体验高度依赖首 token 延迟与生成速度。多 Token 预测从训练阶段的建模技巧,正逐步走向端侧推理的实用优化手段;而冻结策略则把这种优化变成可分发、可复用的组件。对关注端侧 AI 的从业者而言,这条路线提示了一个方向:在不牺牲主模型能力的前提下,通过附加的预测头或模块提升解码效率。
博客原文未在标题与摘要层面披露具体加速幅度与实现细节,相关数据与实验设置需查阅原文。