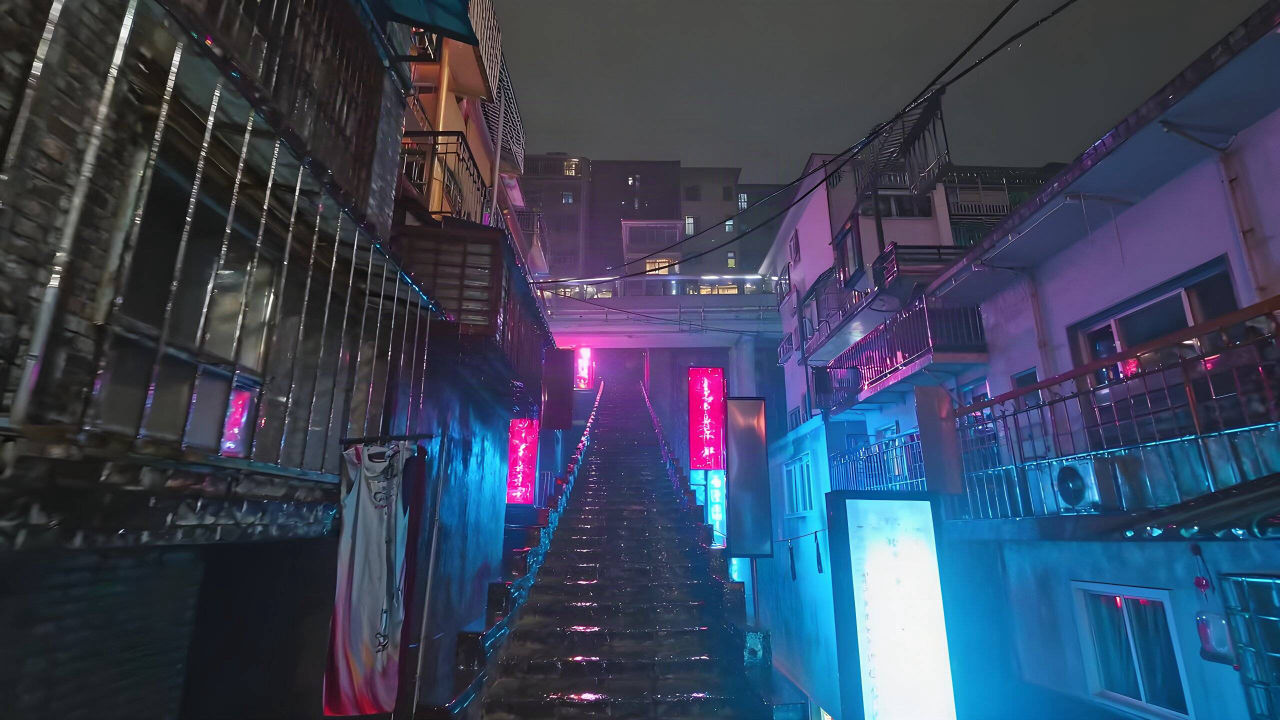
据爱范儿报道,李飞飞团队的最新世界模型已正式开放。文章作者在体验中以一句话作为输入,生成了重庆山城场景。
世界模型通常指能够从图像、文本等输入中构建三维场景、并对场景随动作变化作出预测的模型,被不少研究者视为语言模型之后的重要方向。李飞飞长期主张“空间智能”,强调 AI 需要理解、生成并与三维世界交互。此次的关键词是“正式开放”:这类能力开始从研究演示,转向可被普通用户直接调用的产品形态。
从文章展示的案例看,文本到三维场景的生成已能承载带有复杂地形与密集建筑特征的城市意象,而不只限于单个物体或简单室内空间。一句话即可产出可浏览的场景,意味着内容生产的入口进一步前移——描述即生成,试错成本大幅降低。这对游戏、影视预演、空间设计以及具身智能仿真等高度依赖三维内容的环节,都有直接影响。
与此同时,开放也把问题摆上台面:生成的场景在多大程度上可编辑、可复用,长期一致性与物理合理性如何保证,算力成本与访问门槛能否支撑真实工作流,这些仍需在实际使用中检验。
对 AI 从业者而言,这条消息的价值不只是一次演示效果,而是一个信号:三维世界生成正在进入“可用”阶段,围绕它的工具链与应用形态,可能会像此前的图像、视频生成一样快速铺开。